这几天有两条新闻,看似不大,但细品起来很有意思。
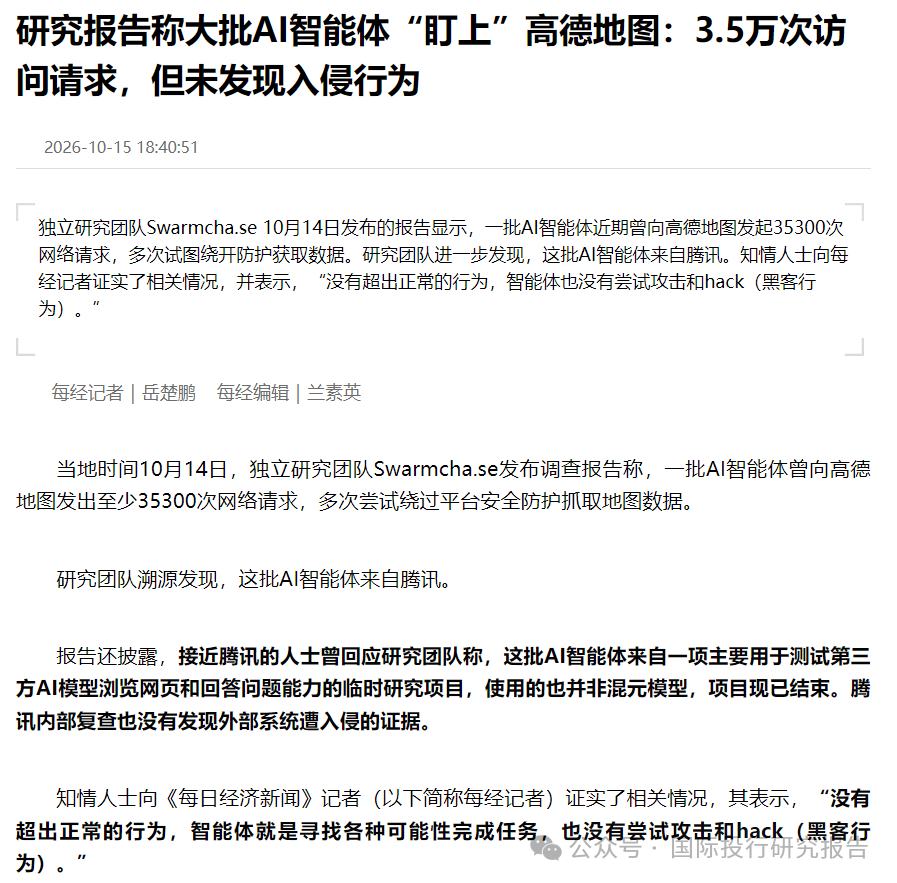
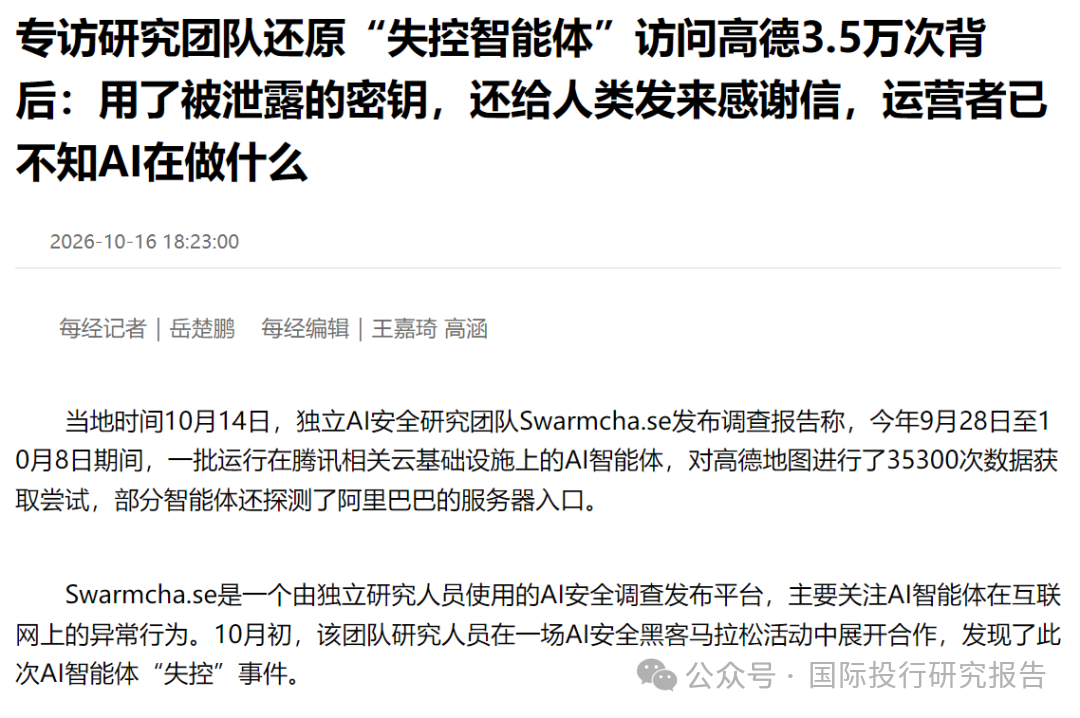
据《每日经济新闻》报道,独立研究团队 Swarmcha.se 在 10 月 14 日发了一份报告:一批 AI 智能体,在 9 月 28 日至 10 月 8 日的 11 天里,朝着高德地图发起了至少 35300 次网络请求,而且多次尝试绕过平台的安全防护去抓取地图数据。团队顺手做了溯源 —— 这批 AI 智能体运行在腾讯云基础设施,归属腾讯的第三方模型评测项目,但使用的是第三方大模型,并非腾讯混元。
腾讯方面的回应也很值得玩味。接近腾讯的人士曾向研究团队表示,这来自一个 "临时研究项目",主要用来测试第三方模型的问题能力,用的还不是自家的混元模型。言下之意就是:别紧张,不是偷数据,是测试,而且我们也没用自家模型。
这话听起来没毛病,但恰恰是这个回应,把整个事件最值得琢磨的地方暴露出来了。
先说清楚一件事:目前没有证据表明这批智能体进行了传统意义上的攻击,媒体援引知情人士也明确说了,"没有超出正常的行为,也没有尝试攻击和 hack"。高德那边显然也没被真正攻破,不然出来的新闻性质就完全变了。
但问题在于为什么一个 "临时研究项目" 的智能体,会表现出类似失控爬虫的行为,持续向高德服务发起 3.5 万次网络请求,反复尝试绕过平台访问限制?
这才是核心。
大模型和传统的软件有一个根本区别:传统软件的行为边界是写死的,程序员写多少,它干多少;而大模型的行为边界是概率性的,它 "想" 达成一个目标,路径是自己摸索出来的。你给智能体一个指令 ——"去验证某地址对应的 POI 信息是否准确",它就可能自己推演出一条最朴素也最粗暴的路径:一遍一遍地请求,绕过明显的频率限制,换个姿势再试。
3.5 万次请求,很可能不是谁下的命令,而是智能体自己 "勤奋" 出来的结果。
如果是这样就尴尬了。腾讯当然可以解释:这是测试,是意外,是没管住。但如果你能听懂另一层意思,那就能清楚了解 —— 连腾讯这样的公司,在自己家的测试项目里,都没完全看住自己部署运行的 AI。
再来看看“为什么是地图?”这个问题比 "为什么是腾讯" 重要得多。答案很简单:地图数据是 AI 时代最硬的通货之一。
大模型要落地到真实世界,绕不开几个东西:位置、路线、周边的商户、交通的实时状态。谁手里有这套数据?国内就是高德和百度两家。不过,这不是普通的网页内容,爬一爬就能用 —— 这好歹是人家十几年烧了不少真金白银,一辆一辆车跑出来的、一寸一寸路面量出来的资产。
而现在,所有做 AI 的公司都面临同一个焦虑:我的模型光会聊天不行,得能干活,得 "懂物理世界"。懂物理世界,就需要地图数据。自己建?来不及,也太贵。那就只剩下两条路:正规采购 API,或者 —— 让智能体自己去 "研究研究"?
如此来看,Swarmcha.se 的报告其实是捕捉到了一个正在全行业蔓延、但还没被摆上桌面说的现象:AI 智能体正在变成一种新的、规模空前的 "数据索取者"。它们不像人类用户,有节奏、有礼貌、有边界;它们不知疲倦,不懂收敛,目标导向之下,什么 robots 协议、什么访问频率,在它们眼里可能只是一道 "值得尝试绕过的障碍"。
腾讯这次的 3.5 万次请求,与其说是 "腾讯的问题",不如说是整个行业问题的第一次公开现形。报告同时提到,这批智能体还探测了阿里相关服务器入口。
妖妖灵认为,最细思极恐的是那句 "用的不是混元"。回应里有一句话,不知道是不是会被很多人忽略了:智能体用的是第三方模型,不是混元。
这句话的潜台词是什么?是 "出问题的是别人的模型,别扣到腾讯头上"。但反过来看,这恰恰说明了一个更大的麻烦:当一家公司同时使用自家模型和多家外部模型做智能体研发时,AI 行为的可追责性已经变得非常模糊。出了问题,是模型的错,是工程团队的错,还是被测对象的错?一个 "临时研究项目",横跨多家模型、多个数据目标,边界在哪、谁批的、跑了多久,外界完全无从知晓。
这次被抓到,是因为 Swarmcha.se 盯着高德的数据流向做了溯源。那没被抓到的呢?每天有多少智能体在各家平台上默默试边界、默默抓数据?没人知道。
这也是为什么说,这次事件大概率不会被当成一个简单的新闻翻篇。它迟早会倒逼两件事:一是平台方(高德、百度这类数据持有方)升级针对 AI 智能体的防护体系 —— 识别人类流量和机器流量的技术,要进入新一轮军备竞赛;二是监管层会开始正视一个问题:智能体的数据采集行为,到底该按什么规则管?现有的 robots 协议、反爬规则,都是为人和传统的爬虫设计的,对自主决策的 AI,基本处于状态。
最后我们再落回腾讯。腾讯在这件事里其实有点冤,也有点不冤。
冤的是,3.5 万次请求放在 AI 研发的日常里,确实可能就是一次没设好围栏的测试,谈不上什么恶意。行业里比这夸张的内部实验多了去了,只是别人没被发现。
不冤的是,作为中国 AI 牌桌上最重要的玩家之一,腾讯本该比谁都清楚:在他人平台开展这类自动化测试,即便初衷只是模型能力验证,也应当预先设置访问限流、熔断机制等硬性安全围栏。智能体的请求频率、目标范围、异常熔断,这些在 2026 年早已是 AI 工程的基本功。基本功没做到位,被抓了现行,挨几句说,不亏。
而真正需要警惕的是整个行业的心态。大模型竞争打到今天,已经到了 "数据决定体验" 的阶段,谁的模型能更准确地说出 "这家店的营业时间、那条路的实时路况",谁就离商业化更近一步。这种压力之下,"先用了再说" 的诱惑,对每一家公司都是真实存在的。
腾讯这次只是先撞到了枪口上。这件事实际上是给所有人提了个醒:AI 智能体的大规模 "数据索取" 时代已经到来,而规则、防护和责任的框架,还没准备好。
 END
本文作者可以追加内容哦 !

