本文由半导体产业纵横(ID:ICVIEWS)综合
2029~2031年,SK海力士将会推出HBM5、HBM5E等标准解决方案。
11月3日,在韩国首尔举行的“SK AI Summit 2025”峰会上,韩国存储芯片大厂SK 海力士(SK hynix)CEO Kwak Noh-Jung 正式宣布转型“全线AI存储创造者”(Full Stack AI Memory Creator)的新愿景,并公布了公司最新的产品路线图。
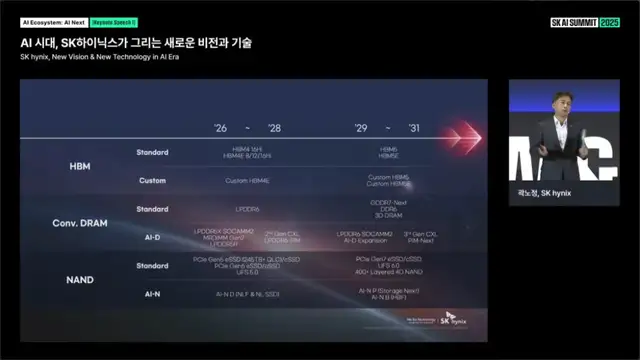
在2026~2028 年的近期,SK海力士将会推出HBM4 16Hi 和 HBM4E 8/12/16Hi等标准解决方案,还有为客户定制的 HBM 解决方案。其中,定制化HBM通过将原有系统半导体的部分功能转移至HBM基底芯片,实现最符合客户需求的数据处理性能。
在DRAM方面,SK海力士除了将推出LPDDR6标准解决方案外,还将推出全新的AI-DRAM解决方案,包括2026年左右推出的LPDDR6X SOCAMM2、MRDIMM Gen2、LPDDR5R,以及2028年左右推出支持第二代CXL标准的LPDDR6-PIM。
在NAND方面,SK海力士将会推出PCIe Gen6 eSSD(245TB+QLC)/ cSSD、PCIe Gen6 eSSD/cSSD、UFS 5.0 等标准解决方案,还会推出全新的面向 AI NAND的 AI-N D(Density)解决方案。
对于2029~2031 年的中期,SK海力士将会推出HBM5、HBM5E等标准解决方案,还有为客户定制的 HBM5和HBM5E解决方案。
在DRAM方面,SK海力士将会推出 GDDR7-next、DDR6、3D DRAM等标准解决方案;需要指出的是,目前GDDR7的速率为30-32Gbps,三星是第一个为英伟达的RTX 50和RTX50 PRO Blackwell GPU提供GDDR7 DRAM的公司,几个月后美光和SK海力士也加入了这一行列。不过,GDDR7最高传输速率是48Gbps,预计该标准至少要到2027年至2028年才能得到充分利用;DDR6则预计是在2029-2031年商用;至于3D DRAM,则有点类似HBM,不过成本更低。
SK海力士还将会推出面向AI的AI DRAM产品,包括2029年左右推出的LPDDR6 SOCAMM2 、Al-D Expansion,以及2030年左右推出的第三代CXL标准的PIM-next。
在NAND方面,SK海力士将会推出PCIe Gen7 eSSD/cSSD、UFS6.0、400层以上堆叠的4D NAND等标准解决方案,以及面向AI的AI-N P(Performance)和AI-N B(Bandwidth)解决方案(比如HBF)。
根据此前韩国科学技术研究院(KAIST)内存系统实验室和 TERA 互连与封装团队展示的高带宽内存(HBM)从 HBM4 到 HBM8 的前瞻性路线图。
HBM4:计划于2026 年推出,是 HBM 技术迈入模块化架构的起点。其 I/O 数量达 2048,数据速率为 8Gbps,总带宽突破 2TB/s。堆叠层数扩展至 12 或 16 层,单颗容量提升至 24Gb,整颗模块可达 36 至 48GB。此阶段引入定制化基底芯片,将 NMC 处理器与 LPDDR 控制器集成其中,系统级内存容量可提升 40%。
HBM5:预计2029 年问世,重点转向 “计算靠近内存” 的 3D 异构架构。它保留 8Gbps 速率,通过将 TSV 数量扩展至 4096 通道,带宽提升至 4TB/s,容量升至 80GB。实现了 3D 近内存计算(NMC),处理器核心与 L2 缓存 die 堆叠于 DRAM 之上,可显著提升 GEMM 类任务的算术强度,对于内存受限场景能实现 3 倍性能增益。
HBM6:将于2032 年推出,数据速率提升至 16Gbps,带宽跃升至 8TB/s,容量达 96 至 120GB。结构上采用 “四塔结构” 整合四个堆叠单元,在硅中介层上与 GPU 形成宽带连接,可使 LLM 推理量相较 HBM4 提升超过一倍。同时引入硅 - 玻璃混合中介层,以解决硅中介层在尺寸与成本上的限制。此外,还内嵌 L3 缓存,可有效减少 HBM 访问量 73%,整体能耗降低 40%。
HBM7:预计2035 年推出,以内存 - 存储一体化为目标,构建由 HBM 与高带宽闪存(HBF)联合构成的异构存储网络体系。数据速率进一步提升至 24Gbps,总带宽达 24TB/s,单颗模块容量上探至 192GB,I/O 数量增至 8192 通道。通过堆叠 128 层 NAND 闪存构成 HBF,与 HBM 间通过高带宽 H2F 链路连接,形成 17.6TB 容量的分层存储架构。
HBM8:将于2038 年问世,以 “全 3D 集成” 和 “内存中心计算” 为核心理念。数据速率攀升至 32Gbps,总带宽高达 64TB/s,模块容量扩展至 240GB,I/O 数量倍增至 16384 通道。将 GPU 堆叠至 HBM 之上,计算延迟下降 50%,还将矩阵运算的执行路径直接移入 HBM 模块,令牌生成速率提升近 7 倍。
如此来看,SK海力士的路线图与KAIST所展示的路线图规划相契合,届时冷却可能会成关键竞争因素。目前 HBM4 使用的液冷方法(将冷却液施加到封装顶部的散热器上)在未来将面临局限性。为此,HBM5 结构预计将采用浸没式冷却,将基座芯片和整个封装都浸入冷却液中。
*声明:本文系原作者创作。文章内容系其个人观点,我方转载仅为分享与讨论,不代表我方赞成或认同,如有异议,请联系后台。
本文作者可以追加内容哦 !

