在沙龙的交流环节,一位老师提出了一个核心问题:“我知道‘低估值+高成长’是好逻辑,但在机器学习的世界里,如何证明这不仅是‘马后炮’式的解释?”
我的回答很简单:AI不听“我觉得”,它只看“数据验证”。
作为一名估值研究者,我习惯了处理不确定性。而在量化领域,所有投资直觉在进入实盘前,都必须经过严谨的“脱水”验证。
1. 投研“脱水”的工具箱:机器学习模型在我的系统中,机器学习模型负责将海量数据转化为可执行的策略。针对不同数据源,分工如下:
• 给基本面脱水(寻找“价值之锚”):普通投资者看财报是“看三年”,模型可以“看二十年”。利用 LGB 或 XGB 等集成学习模型,通过数百个财务因子,去学习 A 股历史上的盈利质量规律与现金流溢价。它挖掘的是指标背后隐藏的因果逻辑,旨在通过模型给出一个脱去水分的底层估值。 • 给动能做判断(寻找“阻力最小的前进路径”):
动能分析负责捕捉市场节奏。在这里,我更倾向于使用微软开源的 Qlib 框架。它内置了 alpha158、alpha360 这样经过验证的量价因子库。这些量价因子为模型提供了不同维度的输入,帮助我们从价格波动中剥离出具备统计学意义的信号。
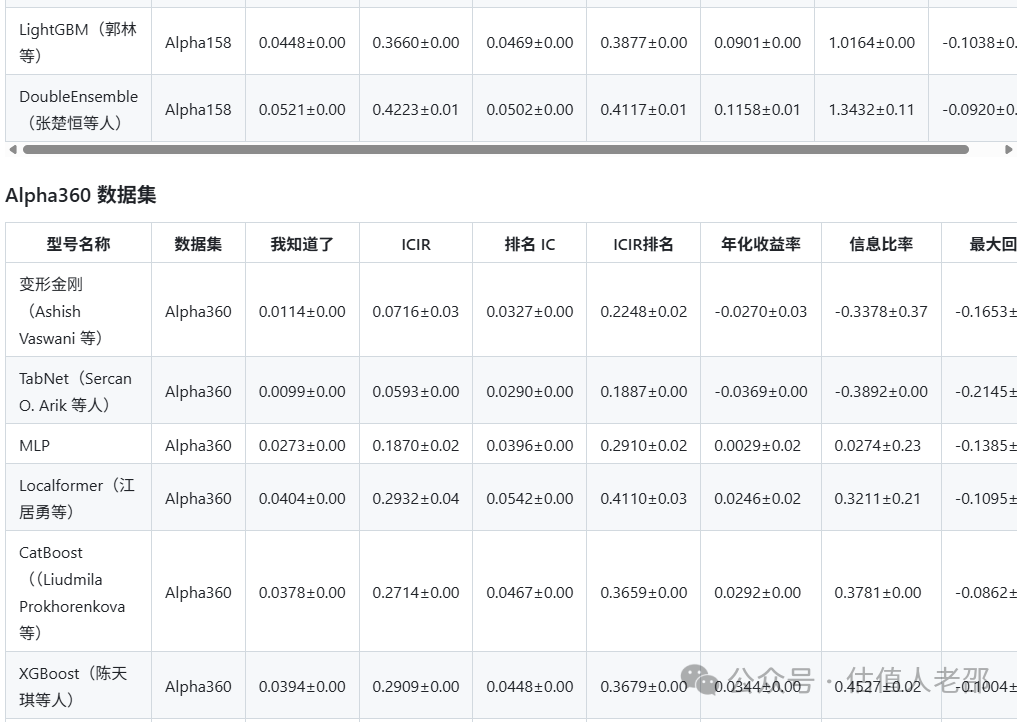 https://github.com/microsoft/qlib/blob/main/examples/benchmarks/README.md 2. 回测三问:你是在看未来,还是在看现实?
很多量化策略在回测里是神,在实盘里是鬼,通常是因为忽略了以下现实约束:
1. 手续费与滑点成本:高频 Alpha 的收益极易被单笔交易成本吞噬。2. 未来函数:这是初学者最易犯的错误。策略在判断“今天”买入时,是否无意中引入了“明天”的信息? 3. 幸存者偏差:回测样本是否包含了那些已经退市或暴雷的公司?如果只在现在的绩优股里找历史规律,逻辑必然失效。[!RISK] 真实教训:
我刚开始做实盘测试时,为了平滑交易,设计了“多次小额随机买入”。但我忽略了 A 股单笔最低 5 元手续费的硬约束,导致一笔 2500 元的小额成交,实际手续费率高达 0.2%,直接比预想的“万二”佣金贵了 10 倍。
3. 稳定性比收益率更“值钱”
在 AI 量化中,最危险的行为是过拟合。为了让历史曲线好看而不断堆砌参数,本质上是在“刻舟求剑”。
因此,建立严谨的**“样本外测试”**是防范逻辑失效的底线:
• 训练/测试集的刚性切分:必须预留一段模型“从未见过”的历史数据作为盲测区。 • 对抗非平稳性:由于金融规律具有时效性,只有在完全陌生的环境下依然稳健的逻辑,才具备实战价值。在量化世界,稳定性不是一种选择,而是抵御波动韧性的唯一来源。
下一篇,我将转向非结构化数据的处理:如何通过提示词范式优化宏观研究。
研究附录:工具与口径说明
文中部分结论来自本人维护的研究工具(用于数据整理与口径一致性校验,不构成投资建议):
• 财务体检模块:结构化拆解财报并打分 • 估值框架模块:综合估值模型结果访问方式:公众号「估值人老邵」菜单栏 →「服务」
边界声明:本文及相关工具仅供研究与学习使用,不构成任何投资建议。据此入市,风险自担。
追加内容
本文作者可以追加内容哦 !

