英伟达千亿押注硅光革命:CPO与OCS如何重塑AI计算未来
原创 糖不苦同学 半导体行业小报
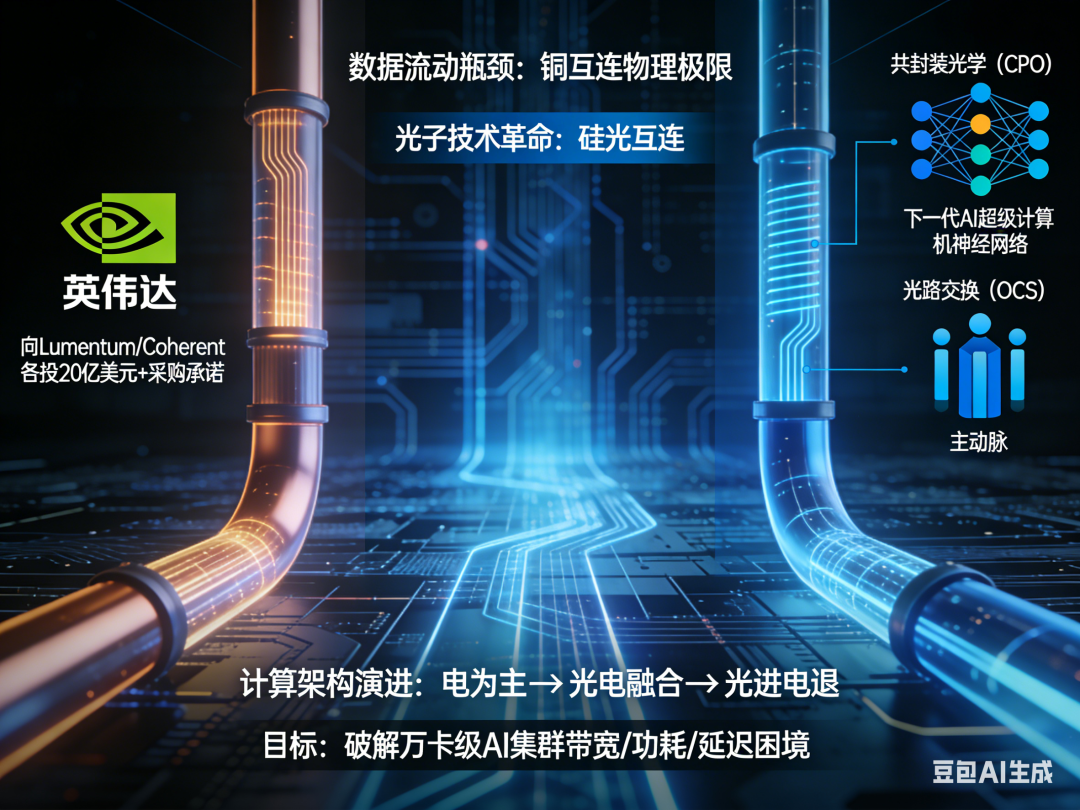
在人工智能算力需求呈指数级增长的今天,数据在芯片间高速流动的“管道”已成为制约整个系统性能的关键瓶颈。当电子信号在铜互连中遭遇物理极限,一场由光子技术驱动的连接革命正悄然拉开帷幕。英伟达,这家凭借GPU主宰AI计算市场的巨头,正以前所未有的力度押注硅光技术,试图从根本上重构未来计算基础设施的互连范式。通过分别向光通信领域的两大核心供应商Lumentum和Coherent各投入20亿美元,并附加数十亿美元的采购承诺,英伟达不仅锁定了未来先进激光器与光网络产品的产能,更清晰地昭示了其技术路线图:共封装光学(CPO)与光路交换(OCS)将成为下一代AI超级计算机的神经网络与主动脉。这场战略布局远不止于简单的供应链投资,它标志着计算架构正从“电为主、光为辅”的传统模式,向“光电融合、光进电退”的新时代全面演进,其目标直指破解万卡级AI集群的带宽、功耗与延迟三重困境。
战略纵深:从Mellanox收购到百亿投资,英伟达的光学野心演进
英伟达对光通信技术的战略重视并非一蹴而就,其布局可以追溯到七年前的一笔关键收购。2020年初,英伟达以690亿美元的天价收购了网络互联公司Mellanox Technologies,此举不仅让英伟达获得了高性能计算网络(InfiniBand)和以太网的技术主导权,更使其一举成为高端光收发器的重要销售商。然而,鲜为人知的是,Mellanox自身的光学基因早在2013年就已埋下——通过收购硅光子技术公司Kotura和高速电芯片设计公司IPtronics,Mellanox敏锐地预见到光互连在未来数据中心中的核心地位,并开始了技术储备。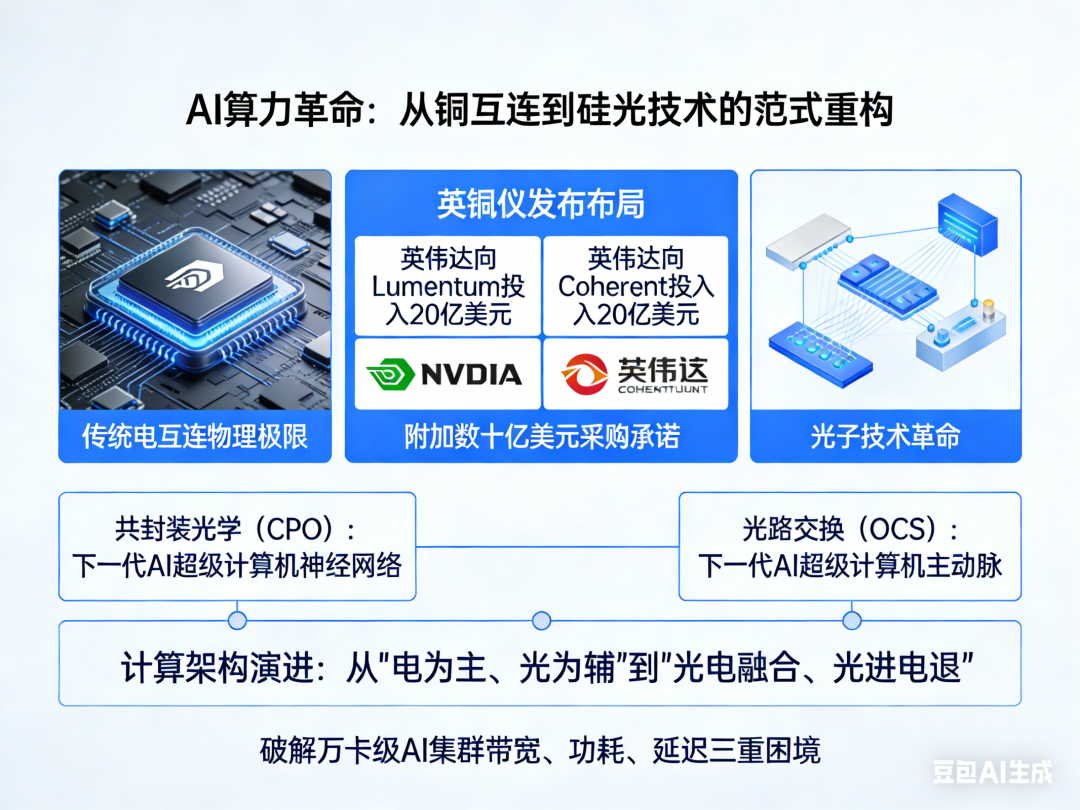
尽管Mellanox曾怀揣打造自有光收发器业务的梦想,但在2017年拒绝Marvell的收购提议后,公司陷入与激进投资者Starboard Value的争执,其垂直整合光模块的计划被迫搁浅,业务规模大幅收缩。此后,为了发展其至关重要的LinkX光缆与收发器业务,Mellanox转向从Lumentum(后与II-VI合并成为Coherent)等外部供应商采购激光器、光子集成电路(PIC)等核心组件。在高端AI系统中,这些光互连组件的成本可能占据整个网络成本的50%以上,功耗占比同样惊人,因此LinkX业务线对Mellanox乃至整合后的英伟达而言,其战略重要性不言而喻。
随着AI模型参数突破万亿,训练集群规模向数万乃至数十万张GPU扩展,传统可插拔光模块和铜缆互连在带宽密度、功耗和信号完整性方面日益捉襟见肘。设计更先进AI系统的严峻挑战,以及最终用光学电路大规模替代电子电路的迫切需求,迫使英伟达采取更激进的动作。分别向Lumentum和Coherent注入的20亿美元投资,并非简单的财务入股,而是深度绑定的战略合作。与常见的直接购股不同,这些投资很可能以可转换债券、未来股权或特定权证等形式进行,旨在以资本为纽带,强力驱动两家供应商的研发资源向英伟达的AI目标聚焦。更关键的是,英伟达还给出了“数十亿美元的先进激光组件采购承诺和未来产能使用权”,这相当于为两家公司未来的扩产计划提供了长期订单保障,极大地降低了其投资风险,确保在需求爆发时产能能够及时跟上。
技术核心:共封装光学(CPO)——破解GPU I/O瓶颈的终极钥匙
共封装光学(CPO)技术是英伟达此次战略押注的核心之一,它代表着光互连与计算芯片融合的终极形态。CPO的核心思想是将光引擎(包括激光器、调制器、探测器等)通过先进的2.5D或3D封装技术,直接集成到交换机或计算芯片的封装基板或中介层上,从而将高速电信号的传输距离从厘米级缩短到毫米级。这种架构变革带来了革命性的优势:功耗可降低40%以上,带宽密度提升数倍,信号延迟大幅减少,同时还能显著节省空间并提高可靠性。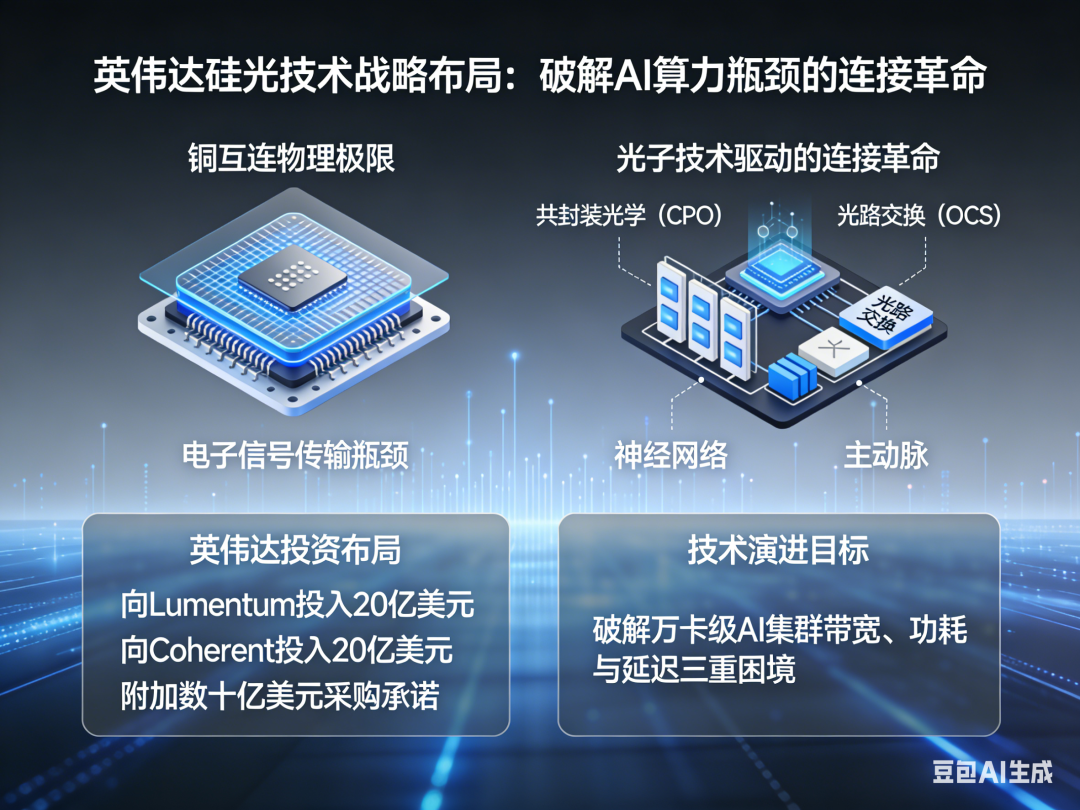
Lumentum和Coherent都深度参与了英伟达即将推出的Quantum-X InfiniBand和Spectrum-X以太网交换机的CPO项目。据信,Lumentum为这两款交换机的CPO模块提供核心激光器。然而,英伟达的布局显然更为长远和审慎。其与两家公司签订的非排他性协议明确传递了一个信号:英伟达希望引入并维持供应商之间的竞争。这与其两年前力挺美光科技重返HBM内存市场的策略如出一辙——当时,为了打破三星和SK海力士在HBM领域的双头垄断,英伟达将Hopper Ultra H200加速器的全部HBM容量订单交给了美光,这不仅帮助美光获得了巨额利润和快速的投资回报,也为自己赢得了更有利的供应链格局和议价能力。
将CPO技术从交换机扩展到GPU计算引擎本身,是英伟达技术路线图中更为关键的一步。随着GPU性能的持续飞跃,其I/O带宽需求呈指数增长,而GPU芯片边缘的物理空间(即封装周长)却增长缓慢。多芯片封装(如CoWoS)在提升计算和缓存面积的同时,反而加剧了I/O带宽与芯片周长之间的矛盾。CPO技术通过将光I/O直接集成到GPU封装附近,有望从根本上突破这一“带宽墙”。即使英伟达在其“Oberon”NVL72机架中引入了铜质中板来替代部分线缆,从长远看,在GPU端采用CPO仍是实现更高带宽、更低功耗互连的必然选择。英伟达的投资正是在为这一未来场景储备技术和产能。
网络重构:光路交换(OCS)——打造高效能AI集群的“光速骨干”
如果说CPO解决了芯片级和板卡级的互连效率问题,那么光路交换(OCS)则旨在重构整个数据中心级网络的拓扑与能效。OCS是一种基于全光交换的技术,它允许光信号在光纤之间直接进行路由,无需像传统以太网或InfiniBand交换机那样,进行多次耗电的光-电-光(OEO)转换。其工作原理类似于老式的电话电路交换,通过微镜阵列或液晶等物理机制,在微秒至毫秒量级内建立两点之间的专属光通路。
Lumentum和Coherent在OCS领域同样拥有领先布局,这或许是吸引英伟达投资的另一个关键因素。Lumentum的R300光路交换机基于微机电系统(MEMS)镜技术,与谷歌在其“Apollo”光路交换机中使用的“Palomar”MEMS器件同源。谷歌已将OCS作为其过去四代TPU系统(从TPU v4到TPU v7)的网络骨干,用于构建高达9216个TPU的庞大共享内存域。Coherent则推出了基于液晶技术的DLX系列数据中心光波交叉连接交换机,提供从64x64到512x512端口的多种配置,目前已有七家客户进入试用阶段。
OCS的价值在超大规模AI集群中尤为凸显。对于AI训练这类流量模式相对固定、持续时间长的工作负载,OCS可以建立最优化的静态或半静态光路。Lumentum声称,在一个拥有10万个计算单元(XPU)的AI集群中,采用OCS作为网络主干,可以将整体网络功耗降低高达65%,同时将延迟比传统以太网交换机降低5到10倍。尽管OCS重新配置链路的速度较慢(需要几十毫秒),不适合需要频繁动态重构的网络核心,但对于AI训练集群的顶层骨干网而言,网络拓扑通常在一次任务周期内保持稳定,这恰恰是OCS发挥其低功耗、低延迟优势的完美场景。英伟达未来很可能在其“Rubin Ultra”平台或更后期的架构中,从当前完全连接的胖树拓扑转向环形或蜻蜓拓扑,并使用OCS主干网络将这些计算岛高效连接起来,从而构建能效比极高的超大规模AI超级计算机。
生态博弈:供应链安全、反垄断与未来垂直整合的边界
英伟达的百亿级投资背后,是一场精妙的生态博弈。当前,Lumentum和Coherent的市值分别高达约501亿美元和485亿美元,估值水平已充分反映了市场对AI光通信前景的极度乐观。然而,英伟达直接收购其中任何一家都面临巨大障碍。一方面,收购如此规模的上市公司需要动用巨额资金,并可能引发全球主要反垄断监管机构的严格审查。另一方面,英伟达的主要客户——各大超大规模云服务商和电信运营商——很可能强烈反对这种垂直整合,因为这会将关键的光组件供应集中到其核心算力供应商手中,削弱客户自身的议价能力和供应链多样性。
因此,通过战略投资和长期采购协议进行深度绑定,而非直接收购,成为英伟达更明智的选择。这种模式既确保了英伟达能够获得稳定、优先的先进组件供应,并影响技术研发方向,又避免了完全垂直整合带来的反垄断和客户关系风险。同时,维持Lumentum和Coherent两家供应商的竞争格局,符合英伟达一贯的供应链管理哲学——即通过“多源供应”来确保供应链安全、控制成本并激励技术创新。
从更广阔的视角看,英伟达在硅光领域的布局是其构建全栈AI帝国的重要一环。从计算芯片(GPU)、互联网络(NVLink、InfiniBand、以太网)、系统架构(NVSwitch、机架设计)到现在的底层光互连技术,英伟达正试图掌控从算力产生到数据流动的每一个关键环节。这种垂直整合能力是其维持竞争优势、提升系统级性能与能效、并打造独特生态壁垒的核心战略。硅光技术,特别是CPO和OCS,正是连接其计算帝国各个节点的“光速血管”。
未来图景:硅光技术将如何定义下一代计算范式
英伟达的重磅押注,预示着硅光技术将从辅助性的通信手段,演进为未来计算架构的基础设施。其影响将深远而广泛:
首先,计算与通信的边界将彻底模糊。CPO技术使得光I/O成为芯片封装的内在部分,“计算芯片”将进化为“光计算芯片”。这不仅适用于GPU和交换机ASIC,未来还可能扩展到CPU、DPU乃至专用AI芯片。光电融合的芯片设计将成为新的常态。
其次,数据中心网络架构将发生根本性变革。以OCS为核心的全光骨干网络,结合基于CPO的叶嵴交换,将构建出超高带宽、超低延迟、极致能效的数据中心内部网络。网络拓扑将更加灵活,能够根据不同的AI工作负载(如训练、推理、稀疏模型)动态优化。
再者,供应链和产业格局将重塑。价值将从传统的可插拔光模块组装,向上游的核心光子器件(激光器、PIC)、先进封装和系统集成转移。拥有核心光子技术与芯片级整合能力的企业将占据价值链顶端。材料、制造和测试领域也将迎来新的机遇。
最后,将催生全新的应用场景。极低延迟和超高带宽的光互连,使得更大规模的参数同步训练成为可能,加速万亿参数乃至更大规模模型的开发。同时,它为存算一体、近内存计算等新型架构提供了关键的互联支持,甚至为未来量子计算与传统计算单元的混合架构铺平道路。
总而言之,英伟达向Lumentum和Coherent的数百亿投资,绝非简单的财务行为,而是一份关于未来计算范式的宣言。它标志着以硅光技术为代表的“光进电退”时代正式开启。在AI算力需求的无情驱动下,光子正在从数据的“搬运工”转变为计算的“赋能者”。这场由英伟达引领的硅光革命,终将重新定义芯片如何思考、数据如何流动,以及整个智能世界如何被连接。对于整个半导体和计算产业而言,通往下一代AI超级计算机的道路,已然被点亮。
糖不苦同学
您的支持是我前进的动力~
喜欢作者
内容含AI生成图片
阅读 89
半导体行业小报
关注
1
7推荐
写留言
复制搜一搜
复制搜一搜
本文作者可以追加内容哦 !

